


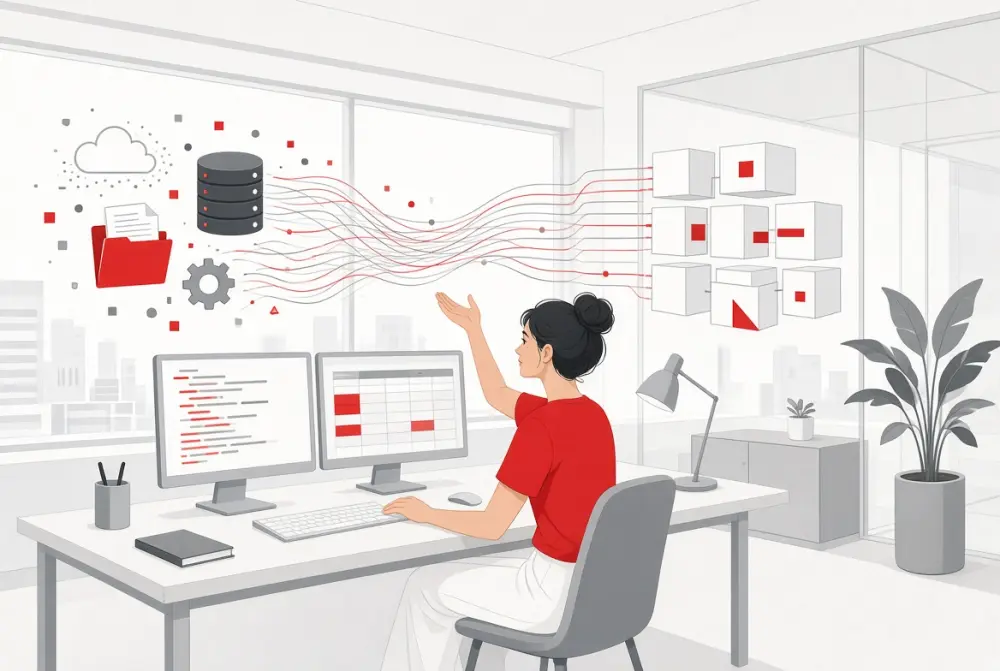


Дата-инженер — это ИТ-специалист, который собирает сведения из разных программ и баз в одно место и следит за их порядком. Это могут быть заказы, платежи, записи о клиентах, результаты измерений — всё, что накапливается в компьютерах. Такая работа нужна многим организациям: интернет-магазинам, банкам, больницам, госучреждениям, заводам. Свести эти сведения вместе, привести к общему виду и проверить, что они не противоречат друг другу, — задача дата-инженера.
Возьмём для примера интернет-магазин. Записи о заказах лежат в одной базе, сведения об оплатах — в платёжном сервисе, о доставке — у логистического партнёра. Дата-инженер настраивает автоматический сбор всей этой информации в одно место, чтобы она приходила вовремя и была корректной. После этого аналитики смогут посчитать продажи, а специалисты по машинному обучению — настроить модель, которая, например, предскажет, какие товары покупатель закажет в следующий раз.
При этом дата-инженер сам не интерпретирует показатели, которые собирает. Например, не думает, почему в магазине упали продажи, а лишь констатирует этот факт. По сути инженер строит фундамент, на котором другие сотрудники, допустим аналитики, уже могут делать выводы. Однако если в данных что-то не сходится, именно инженер разбирается, откуда взялась ошибка.
С дата-инженером часто путают смежные роли
Вот кто чем занимается:
- Аналитик данных исследует информацию, считает показатели и отвечает на вопросы бизнеса: почему упали продажи, какой товар популярен. Он может работать с таблицами, которые подготовил дата-инженер, а может и сам писать запросы к источникам — зависит от компании.
- Специалист по Data Science строит модели машинного обучения: например, предсказывает, какой товар купит клиент или когда он уйдёт к конкурентам. Ему тоже нужны подготовленные данные.
- Администратор баз данных (DBA) следит, чтобы база данных работала без сбоев: делает резервные копии, восстанавливает после аварий, управляет доступами.
- Backend-разработчик пишет серверную часть приложений: логику и программные интерфейсы. Он может обращаться к базе данных, но не отвечает за то, как данные собираются для аналитики.
- Архитектор данных решает, как устроить хранение и движение данных в масштабе всей компании: какие системы использовать, как они связаны, какие стандарты соблюдать.
Дата-инженер и инженер баз данных — одно и то же?
Нет. Формулировку «инженер баз данных» в вакансиях используют по-разному: иногда так называют администратора баз данных, иногда разработчика баз данных, иногда дата-инженера. Все они работают с базами, но решают разные задачи.
Например, настроить резервное копирование и восстановить базу после сбоя — задача администратора. А построить конвейер, который забирает данные из пяти систем и складывает их в хранилище для аналитики, — задача дата-инженера. В небольшой компании один человек может делать и то и другое, но это совмещение ролей, а не синонимы.
Кстати, инженерия данных имеет дело не только с огромными объёмами информации. Даже компаниям с небольшим потоком данных нужен дата-инженер: например, чтобы регулярно объединять сведения из CRM, бухгалтерии, сайта и приложения.
Какие задачи решает дата-инженер
Набор обязанностей зависит от проекта и уровня специалиста. В одних компаниях инженеры в основном строят конвейеры и витрины данных. В других создают платформы для больших объёмов информации. В третьих занимаются потоковой обработкой сведений. Поэтому покажем все направления, которые встречаются в работе дата-инженера, — от сбора данных до хранения и проверки. Но помните, что не каждый специалист делает всё сразу: набор задач зависит от компании и уровня.
Итак, вот что может делать дата-инженер.
Собирать данные из источников
Данные редко лежат в одном месте. Скажем, у банка сведения о клиентах хранятся в одной системе, операции — в другой, кредитная история приходит из внешнего бюро, а данные о действиях в мобильном приложении — из системы аналитики. Инженер настраивает автоматический сбор из всех этих мест: из баз данных, через API внешних сервисов, из файлов, которые присылают партнёры, из журналов событий приложения.
Задача — сделать так, чтобы данные приходили сами по расписанию, а не через ручной перенос таблиц. Представьте, если источников пять и каждый обновляется ежедневно, то сотрудник будет тратить часы на копирование, а при малейшей ошибке данные потеряются.
Кроме того, источники иногда меняются. Например, кредитное бюро обновило формат ответа API. Если это вовремя не заметить, загрузка сломается — и банк не увидит часть кредитных историй, когда будет принимать решение по заявке клиента.
Преобразовывать данные
Исходные сведения редко сразу подходят для аналитики: в них бывают дубликаты, пропуски, разные форматы дат, разные обозначения одного и того же. Скажем, клиент магазина может быть записан в одной системе по одному идентификатору, а в другой — по другому. Суммы заказов могут храниться в разных валютах, время в разных часовых поясах.
Инженер приводит данные к общему виду: объединяет информацию о клиенте из разных систем, стандартизирует валюты и время, проверяет идентификаторы, убирает дубликаты и готовит таблицы для аналитики. Для этого он пишет SQL- и Python-код, настраивает последовательность задач и проверяет, что готовый конвейер работает по расписанию. Подход здесь может быть разным: ETL или ELT. Выбор зависит от платформы, объёма данных и требований к скорости обработки.
Проектировать хранилища
Инженер решает, где и как накапливать информацию. Это может быть хранилище данных, озеро данных или lakehouse.
Выбор зависит от нескольких факторов. От того, какие данные нужно хранить: только структурированные таблицы или ещё файлы, логи и изображения. От нагрузки: сколько запросов одновременно идёт к хранилищу и насколько быстро они должны отвечать. От стоимости: сколько компания готова платить за хранение и вычисления. И от того, какая инфраструктура уже есть — например, использует ли компания облако или собственные серверы.
Когда место выбрано, инженер продумывает, как внутри него разложить данные. Он проектирует таблицы, готовит витрины для конкретных задач и следит, чтобы пользователи понимали, что в этих таблицах лежит. Например, аналитику нужен отчёт по продажам по категориям товаров. Инженер решает, из каких таблиц этот отчёт собирать, как они связаны между собой и как часто обновляются, — и создаёт витрину, из которой аналитик сможет этот отчёт построить.
Настраивать автоматизацию и оркестрацию
Конвейеров может быть много, и каждый нужно запускать в правильном порядке, который зависит от цели. Допустим, каждый понедельник руководитель магазина смотрит отчёт о продажах: какие товары уходят быстрее, какие залежались, что пора заказать у поставщиков. Чтобы отчёт был готов к утру, данные должны пройти цепочку: сначала загружаются заказы и платежи, потом обновляется витрина продаж, затем пересчитываются показатели. Если запустить отчёт раньше, чем загрузились платежи, цифры будут неполными — и руководитель примет решение вслепую.
Чтобы всё шло по порядку, используют инструменты оркестрации, например Apache Airflow. Они запускают задачи в нужной последовательности и следят за их выполнением.
Следить за качеством и надёжностью данных
Если в хранилище попадают неверные или устаревшие данные, проблемы затрагивают отчёты, решения сотрудников и модели машинного обучения. Представьте: аналитик строит отчёт о продажах, а в данных дубликаты, один и тот же заказ записан дважды. Руководитель видит завышенные цифры и заказывает у поставщика больше товара, чем нужно — это прямые финансовые потери компании.
Инженер как раз предотвращает такие ситуации. Для этого проверяет данные на трёх уровнях:
- Всё ли на месте. Не пропали ли обязательные записи — например, не потерялись ли заказы за день. И заполнены ли обязательные поля: не осталось ли заказов без суммы или клиентов без имени.
- Нет ли лишнего. Скажем, не задвоился ли один и тот же заказ.
- Не изменился ли источник. Допустим, если платёжный сервис поменял формат ответа, инженер должен узнать об этом раньше, чем данные испортятся.
Выбирать пакетную или потоковую обработку
Данные можно обрабатывать по-разному, и выбор зависит от задачи. При пакетной обработке система забирает данные периодически — раз в час или раз в сутки — и обрабатывает за один запуск. Это подходит для большинства отчётных задач: например, интернет-магазину достаточно обновлять отчёт о продажах раз в день, чтобы планировать закупки.
При потоковой обработке события обрабатываются почти непрерывно по мере поступления. Это нужно, когда ждать нельзя. Например, банк отслеживает подозрительные транзакции в реальном времени. Если по карте платят в двух городах одновременно, это может стать сигналом для дополнительной проверки — и данные о транзакции должны дойти до системы вовремя.
Инженер может специализироваться на одном подходе или работать с обоими.
Отвечать за безопасность и стоимость инфраструктуры
Инженер участвует в настройке доступа: помогает сделать так, чтобы сотрудники видели только те данные, которые нужны им для работы. Например, информация о клиентах нужна менеджерам по продажам, а о зарплатах — отделу кадров и бухгалтерии.
Инженер думает не только о том, чтобы данные были правильными, но и о том, чтобы их обработка не стоила слишком дорого. Например, если один и тот же тяжёлый запрос запускается каждую минуту без необходимости, компания платит за вычисления впустую. Поэтому опытный специалист выбирает решение, которое работает быстро и не съедает лишние ресурсы.
Что должен знать и уметь дата-инженер
Дата-инженеру нужна база, без которой не обойтись в любом проекте, и инструменты, которые выбирают под конкретную задачу. Рассмотрим только основные знания и навыки:
- Знать SQL — язык запросов к базам данных. С его помощью инженер достаёт нужные сведения, объединяет таблицы и преобразует данные. Например, аналитик просит информацию о заказах за месяц по категориям товаров. Инженер пишет запрос, который соединяет таблицу заказов с таблицей товаров, считает сумму по каждой категории и отдаёт результат. Без SQL не обходится почти ни один проект: даже если инженер пишет в основном на Python, работу с данными он всё равно делает через запросы.
Программировать на Python — языке для автоматизации и обработки данных. На нём пишут скрипты, небольшие программы, которые выполняют рутинные действия без участия человека. Скрипт может сам скачать данные из API, разложить файлы по папкам, пересчитать суммы или привести даты к одному формату.
Скажем, каждую ночь такой скрипт может забирать информацию из платёжного сервиса, проверять, что все платежи на месте, и складывать их в базу. И всё это без сотрудника, который вручную копировал бы таблицы. Python удобен для таких задач, поэтому распространён в инженерии данных. Но он не единственный: в некоторых командах пишут на других языках.
Моделировать данные — раскладывать информацию по таблицам так, чтобы она оставалась понятной. Инженер решает, что хранить в одной таблице, что в другой и как их связать. Представьте таблицу заказов интернет-магазина.
В каждой строке — заказ, и рядом записаны данные покупателя: имя, адрес, телефон. У одного человека может быть десять заказов, а значит, его адрес повторяется десять раз. Но что если покупатель переехал? Нужно поменять адрес во всех десяти строках. Если где-то забыть — в базе окажутся два разных адреса одного и того же человека, и никто не поймёт, какой правильный. Поэтому данные покупателя часто выносят в отдельную таблицу — «Клиенты». А в заказе оставляют только номер клиента. Тогда адрес хранится в одном месте, и при переезде достаточно поменять одну строку. Это не единственный способ: в аналитических хранилищах иногда, наоборот, дублируют данные намеренно, чтобы запросы работали быстрее.
Понимать ETL/ELT — как данные движутся от источника до потребителя. Данные редко попадают в отчёт напрямую. Сначала их забирают из источника, потом чистят и преобразуют — убирают дубликаты, объединяют таблицы, считают показатели, — и только затем кладут в хранилище или витрину. Порядок этих шагов и называют ETL или ELT, мы говорили о них в прошлом разделе.
Допустим, в базе магазина один и тот же заказ записан дважды. Если дубликат не убрать по дороге, отчёт покажет завышенные продажи. Инженер должен понимать, на каком именно шаге возникла ошибка, — иначе будет искать причину наугад.
Управлять порядком задач — настраивать оркестрацию. Инженер описывает, какие шаги должны выполниться, в каком порядке и при каких условиях. Например, витрина продаж обновляется только после того, как загрузились заказы и платежи. Но главное — что делать, когда что-то ломается. Представьте: конвейер состоит из пяти шагов — загрузка заказов, загрузка платежей, объединение данных, расчёт показателей, выгрузка в отчёт. На третьем шаге что-то упало. Если запускать весь конвейер заново, придётся повторно загружать заказы и платежи, которые уже загрузились, — это лишние минуты и лишние деньги за вычисления.
Поэтому инженер настраивает так, чтобы можно было перезапустить только упавший шаг. Но тут важно продумать зависимости: повторный запуск не должен продублировать данные, которые уже обработались, или сломать то, что работает.
- Тестировать и контролировать качество — проверять и программу, и результат. После загрузки данных инженер проверяет, что все заказы имеют сумму, даты в правильном формате, а дубликатов нет. Например, конвейер отработал без ошибок, но в данных оказался заказ, у которого итоговая сумма не сходится с суммой позиций и скидок. Если это не заметить, отчёт покажет неверные цифры. Инженер настраивает проверки, которые ловят такие ошибки до того, как данные дойдут до аналитика.
- Работать с Git и Linux. Git — система контроля версий: она запоминает все изменения в коде, чтобы можно было откатиться к рабочей версии. Linux — операционная система, которую используют на серверах. Скажем, если инженер обновил код конвейера и после этого данные перестали загружаться, то через Git можно вернуться к предыдущей версии. Работа восстановится. Без такой возможности пришлось бы вручную искать, что именно сломалось.
Это основа, которая нужна любому дата-инженеру. Но есть и другие умения, которые зависят от проекта: работать с потоковой передачей событий, обрабатывать большие объёмы распределённо, выбирать базы данных под задачу, использовать облачные платформы. На одних проектах эти навыки нужны, на других нет. Инженер осваивает их по мере необходимости.
Кому подойдёт профессия
Дата-инженерия подойдёт человеку, которому нравится программирование, логика и устройство информационных систем. Здесь меньше визуализации и интерпретации результатов, чем в аналитике, а большая часть работы связана с инфраструктурой и надёжностью процессов. Вот какие качества помогают:
- Интерес к устройству информационных систем. Почему один сайт грузится быстро, а другой медленно? Что произойдёт, если один из сервисов откажет? Скажем, увидев, что отчёт обновляется с задержкой, такой человек захочет выяснить, на каком этапе теряется время: на загрузке, преобразовании или самом запросе.
- Склонность к автоматизации. Дата-инженер постоянно превращает ручные операции в повторяемые процессы. Если кому-то нужно каждую неделю вручную выгружать таблицы и сводить их в один файл, инженер задумается, как сделать так, чтобы это происходило само, по расписанию, с проверками и уведомлениями при сбое.
- Спокойное отношение к отладке. Когда конвейер падает, причина не всегда очевидна. Инженер проверяет одно, другое, третье, пока не найдёт, что именно сломалось. Человеку, который бросает задачу после первой неудачной попытки, в этой профессии будет тяжело.
- Готовность к «невидимой» работе. Дата-инженер редко наблюдает результат своего труда в виде красивого отчёта или отлаженной модели машинного обучения. Его продукт — это надёжный поток данных, на котором строят отчёты и модели другие сотрудники. Если человек может быть доволен тем, что созданная им система просто хорошо работает и ею успешно пользуются другие, профессия может подойти.
Сложности профессии
Перечислим главные трудности, к которым нужно приготовиться:
- Источники данных меняются без предупреждения. Внешний сервис может изменить структуру ответа API, партнёр — формат файла, а внутренняя система — схему таблицы. Конвейер, который работал месяцами, может сломаться за одну ночь, и разбираться в причине придётся инженеру.
- Ошибки не всегда очевидны. Программа может завершиться без технического сбоя, но данные в ней окажутся неверными: не тот формат даты, задвоенные записи, потерянные значения. Такие проблемы иногда проявляются только в итоговых показателях, когда другие сотрудники заметят, что цифры не сходятся.
- Конвейеры нужно не только создавать, но и поддерживать. Значительная часть работы — это не разработка новой архитектуры, а проверка уже существующих процессов, отладка и реагирование на сбои. Тем, кто хочет постоянно делать что-то новое, может не хватать разнообразия.
- В командах, отвечающих за критически важные системы, возможны дежурства. В некоторых компаниях инженерам приходится дежурить. Скажем, если ночью сломается конвейер, от которого зависит утренний отчёт для руководства или работа операционной системы, кто-то должен поднять его до начала рабочего дня. Такие дежурства бывают не везде: в одних компаниях вообще нет, в других расписаны по графику.
Коротко: это профессия для тех, кому интереснее строить и поддерживать системы, чем интерпретировать данные. Здесь мало видимого результата и много процесса — если такой вид работы вас привлекает, профессия может подойти. Если ближе искать в данных закономерности и обсуждать показатели с руководителями, это уже аналитика. В этом случае присмотритесь к профессиям «BI-аналитик» или «Бизнес-аналитик».
Где работать дата-инженеру
Дата-инженеры нужны там, где данные приходят из многих источников и на них строятся отчёты, решения или автоматизация. Вот основные отрасли:
- Банки и финтех. У банка сведения о клиентах, операциях, кредитах и платежах лежат в разных системах. Инженер собирает их вместе, чтобы аналитики считали показатели, а служба безопасности могла вовремя заметить подозрительную операцию. Здесь особенно строгие требования к надёжности: ошибка в данных о транзакциях может дорого стоить, а доступ к информации ограничен.
- Интернет-сервисы и технологические компании. Пользователи постоянно оставляют цифровые следы: клики, просмотры, покупки, переходы между экранами. Эти события нужно обрабатывать почти сразу, чтобы продукт успевал реагировать. Например, если человек задержался на карточке товара, сервис может показать похожие варианты или подсказку о скидке. Но для этого сообщение о его действиях должно дойти до нужной системы за секунды, а не за час.
- Маркетплейсы и электронная коммерция. Заказы, товары, платежи, доставка, поведение покупателей — всё это нужно свести вместе. Пример с интернет-магазином из начала статьи как раз из этой области.
- Розничная торговля и логистика. Данные приходят из множества точек: со складов, из магазинов, от транспортных систем. Инженер сопоставляет складские запасы, продажи, поставки и маршруты, чтобы компания понимала, где чего не хватает и что пора везти. Например, если в одном магазине заканчивается популярный товар, а на складе в другом городе его лежит тысяча коробок, данные должны показать это вовремя — иначе полки останутся пустыми при переполненном складе.
- Телеком. Сети, абоненты, потребление услуг, платежи за связь — объёмы информации большие, а данные разнородные: от технических логов до счетов. Инженер сводит их так, чтобы оператор видел нагрузку на сеть и понимал, какие услуги востребованы. Например, если в районе города вечером резко падает скорость интернета, данные с вышек и из биллинга должны показать, в чём причина: выросло число пользователей или сломалось оборудование.
- Промышленность и энергетика. Инженер работает с показателями датчиков, сведениями о выработке и потреблении энергии, информацией из корпоративных систем. Скажем, на заводе нужно вовремя заметить, что станок работает не так, как обычно: температура растёт, а детали выходят с браком. Данные с датчиков должны приходить и обрабатываться без задержек — иначе о проблеме узнают только когда оборудование встанет.
- ИТ-интеграторы и компании, оказывающие технологические услуги. Здесь инженер собирает системы обработки данных для разных заказчиков. Одному нужно объединить данные из пяти систем, другому — перенести хранилище в облако, третьему — настроить потоковую обработку. За короткое время можно увидеть разные отрасли и разные архитектуры, от небольшой компании до крупного банка.
- Госсектор и другие организации с развитой информационной инфраструктурой. Ведомства и крупные организации тоже накапливают данные: обращения граждан, статистику, внутренние отчёты. Инженер помогает собрать их в одном месте и настроить обновление — с учётом требований безопасности и ограничений по доступу.
Формат занятости зависит от работодателя. Часть задач можно выполнять удалённо: разработка и мониторинг данных ведутся через корпоративные системы. Но некоторые компании требуют присутствия в офисе или ограничивают удалённый доступ из-за требований информационной безопасности. Офисные вакансии часто встречаются в Москве и Санкт-Петербурге, но удалёнка расширяет географию поиска.
Как искать работу
Вакансии по этой специализации называются по-разному: «дата-инженер», «Data Engineer», «инженер данных», «инженер по данным», «DataOps-инженер», «инженер аналитических данных». Иногда название гибридное — например, «Data Engineer / Analytics Engineer», если работодателю нужен человек на две роли сразу.
Поэтому при поиске описание обязанностей важнее заголовка. Если среди них есть проектирование и поддержка конвейеров, ETL/ELT, SQL и Python, оркестрация, контроль качества данных и работа с хранилищами — это та самая специализация, даже если вакансия называется иначе. И наоборот: «инженер данных» в названии может скрывать администрирование баз данных или аналитическую работу, где инженерии меньше, чем кажется.
Как может развиваться карьера
У дата-инженеров нет одной стандартной лестницы: в разных компаниях отличаются названия уровней специалистов, должностей и распределение ответственности. Но общая логика карьерного роста типичная. Новичок выполняет несложные задачи под руководством наставника, дальше переходит к самостоятельной работе, а в итоге может отвечать за то, как устроена вся система обработки данных в компании, и команду.
Важно
В ИТ-профессиях специалистов делят на три основных уровня: junior, middle и senior. Это рабочая шкала, по которой компании понимают, сколько у человека опыта и что ему можно поручить.
Итак, вот что делает дата-инженер на разных карьерных этапах, если говорить о вертикальном росте:
- Junior пишет SQL- и Python-код, готовит простые преобразования и витрины, тестирует конвейеры. На этом уровне важно научиться работать аккуратно и понимать, что происходит с данными после того, как код отработал. Junior, скажем, может написать запрос, который выдаёт нужные цифры, но ещё не всегда понимает, почему этот запрос работает медленно и что будет, если объём данных вырастет в десять раз.
- Middle уже сам проектирует и поддерживает конвейеры, подключает новые источники, решает проблемы качества и производительности. Middle отличается от junior самостоятельностью: он сам решает, как построить процесс, и отвечает за результат. Может посмотреть на отчёт и сказать: «Здесь загрузка идёт слишком поздно, давайте перенесём её на более раннее время и добавим проверку на пропуски».
- Senior работает со сложными системами, выбирает архитектурные решения, оптимизирует надёжность и затраты, помогает другим инженерам. Понимает, как построить конвейер, зачем компании нужна именно такая архитектура обработки данных, какие у неё ограничения и какие затраты она повлечёт. Например, такой специалист может выбрать более дорогое хранилище, которое выдерживает пиковые нагрузки в чёрную пятницу, — и объяснить руководству, почему переплата оправдана.
- Дальше — руководящие роли. Lead Data Engineer координирует техническую работу команды, отвечает за инженерные стандарты и согласованность решений в компании. Архитектор данных проектирует архитектуру платформы и принципы организации данных на уровне нескольких систем или всей компании. Руководитель направления управляет командой и её процессами: планированием, качеством и достижением технических целей.
Но ещё раз скажем: на рынке труда набор обязанностей для каждого уровня чётко не зафиксирован. Допустим, в одной компании инженер уровня senior всё ещё много программирует руками, а в другой больше отвечает за архитектуру и координацию команды.
Кроме вертикального роста, есть и горизонтальное развитие: стать экспертом в узком направлении или перейти в смежную область. Так, некоторые инженеры углубляются в архитектуру данных, облачную инфраструктуру или DataOps — подход, при котором разработку и поддержку данных автоматизируют так же, как код. Или переходят в аналитику либо Data Science — но тогда придётся дополнительно освоить статистику, бизнес-анализ или машинное обучение. Опыт дата-инженера в этом помогает: такой специалист лучше многих понимает, откуда берутся данные и почему в них бывают ошибки.
Интересный факт
В конце 1980-х — начале 1990-х концепция хранилищ данных оформилась в отдельное направление. Одним из тех, кто её систематизировал, был Билл Инмон — его часто называют отцом-основателем этой области. В 1990 году он опубликовал книгу, где описал, как собрать данные из всех систем компании в одно место, очистить и привести к единому виду, чтобы по ним можно было строить отчёты и принимать решения.
До этого аналитики работали с отдельными выгрузками из каждой системы: сведения о заказах — в одной таблице, об оплатах — в другой, о клиентах — в третьей. Сводить цифры вручную приходилось каждую неделю, и на это уходили дни. Концепция Инмона оказалась настолько удобной, что легла в основу отдельного направления.
Из задач по построению и поддержке таких хранилищ выросла профессия дата-инженера. Правда, сегодня она шире: кроме хранилищ, инженеры занимаются интеграцией данных, распределённой обработкой и облачными платформами.
Рекомендуемые программы обучения
Сколько зарабатывает дата-инженер
Доход зависит от уровня, сложности систем, региона и компании, поэтому одна сумма для всех вводила бы в заблуждение. Но общий ориентир есть: по данным сервиса зарплат Хабр Карьера, медиана по инженерам данных составляет около 255 тыс. рублей в месяц.
На доход влияют несколько факторов:
| Фактор | Как влияет |
| Уровень и самостоятельность | Junior выполняет задачи под контролем, senior отвечает за сложные системы и результат. Разница в оплате может быть кратной |
| Масштаб инфраструктуры | Инженер, который отвечает за платформу для отчётов и моделей всей компании, ценится выше, чем специалист, который работает всего с несколькими конвейерами и в небольшой команде |
| Набор инструментов | Инженер, который знает несколько баз данных, умеет работать с оркестрацией и разбирается в облачных платформах, может претендовать на большие суммы, чем тот, кто освоил только один инструмент. Но ценятся не названия сервисов в резюме, а умение выбрать подходящий инструмент под задачу |
| Отрасль и размер компании | Банки, финтех и крупные технологические компании часто предлагают высокие ставки, но и требования там высокие |
| Регион и формат занятости | В Москве и Санкт-Петербурге ставки обычно выше, чем в других регионах. Удалёнка расширяет географию поиска, но некоторые компании платят удалённым сотрудникам меньше, чем офисным |
| Требования к надёжности и безопасности | Чем выше требования к защите данных, доступности и производительности систем, тем больше ответственности у инженера и тем выше его ценность |
| Архитектурные и руководящие роли | Оплачиваются выше, но требуют принимать решения, объяснять их и отвечать за последствия |
Примеры вакансий (осень 2026 года):
- Дата-инженер (ученик) (Москва). Доход: от 85 тыс. руб.
Аккредитованная ИТ-компания набирает кандидатов без опыта на обучение с последующим трудоустройством. Программа: месяц онлайн-интенсива, затем стажировка 3–4 месяца в учебной лаборатории под руководством наставника. Учат SQL, Python, работе с базами данных и большими данными. Нужно профильное образование. Формат: удалённо на этапе обучения. - Инженер данных / DWH-инженер (Киров). Доход: от 140 тыс. руб.
Агропромышленный холдинг ищет специалиста с опытом 1–3 года. Предстоит внедрять корпоративное хранилище: проектировать структуру таблиц и витрин, очищать данные и следить за качеством, работать с ClickHouse и PostgreSQL, оптимизировать запросы. Нужны уверенный SQL и понимание принципов построения хранилищ. Формат: офис или гибрид. - Data Engineer (Москва). Доход: до 250 тыс. руб.
Предстоит работать на проекте в банковском комплаенсе: реплицировать данные, строить витрины, распространять данные пакетами и интегрироваться со смежными командами. Нужны опыт 3–6 лет, уверенный SQL, разработка ETL-процессов, работа с Hadoop, Hive, Spark, Linux, Java или Python. Формат: офис. - Технический лидер DWH (Москва). Доход: до 380 тыс. руб.
Компания, которая собирает инженерные команды под задачи крупного бизнеса, приглашает специалиста с опытом более 6 лет на проект в банковской сфере. В задачи входит анализировать требования, проектировать архитектуру решений, ставить задачи разработчикам, создавать контроли качества, разбирать инциденты и наставлять команду. Нужны опыт с базами данных (Greenplum, S3), сложный SQL, ETL-инструменты, понимание управления данными. Формат: удалённо или гибрид. - Data Engineer (Москва). Доход: до 480 тыс. руб.
Крупный банк с дата-платформой на сотни петабайт ищет опытного инженера. В задачи входит разработка хранилищ и озёр данных, построение поставки данных в пакетном и потоковом режимах, оптимизация ETL, разработка архитектуры данных, поддержка витрин в Hadoop. Нужны отличный SQL, опыт с Hadoop, Spark, Kafka, Airflow, CI/CD и понимание архитектурных подходов к хранилищам. Формат: офис.
Как стать дата-инженером
В профессию приходят разными путями: через вуз, курсы, самостоятельное обучение с проектами.
Ещё один вариант — перейти из смежной профессии: например, аналитик или тестировщик может доучиться до дата-инженера. Разберём каждый маршрут.
Высшее образование
Самый долгий трек, но даёт основательную подготовку по программированию, базам данных, алгоритмам и математике. Такая база очень помогает, когда появляется новый инструмент: вы будете знать, как он устроен и зачем нужен, а не просто научитесь действовать по инструкции.
Профильные направления в вузах: «Прикладная информатика», «Программная инженерия», «Информатика и вычислительная техника», «Математика» и смежные.
Важный нюанс: в официальном перечне направлений подготовки специальности «дата-инженер» нет. Но это не значит, что учиться негде. Вуз берёт широкое направление, например «Прикладная информатика» или «Информатика и вычислительная техника», и внутри открывает программу с нужным содержанием. В дипломе будет название направления, а не «дата-инженер», но учить будут тому, что нужно: базам данных, конвейерам, обработке данных. Названия программ бывают разными — например, «Инженерия данных» в магистратуре или «Прикладной искусственный интеллект и инженерия данных» в бакалавриате.
Этот путь выбирают, когда хочется не просто выучить набор инструментов, а глубоко понимать, как устроена работа с данными. Диплом о высшем образовании очень пригодится, если в будущем захочется расти до архитектора или руководителя — в крупных компаниях такие позиции часто требуют высшего образования. Но одного диплома для первой работы всё равно может не хватить.
В Университете «Синергия» подойдут программы:
«Прикладная информатика в экономике» (бакалавриат, совместная программа с 1С)
Здесь готовят ИТ-специалистов для бизнеса: учат разрабатывать и сопровождать программное обеспечение, внедрять новые технологии, разбираться в корпоративных системах. Программа смещена в сторону автоматизации бизнес-процессов на платформе 1С, экономики и управления ИТ-проектами.Для дата-инженера это смежный путь, но с сильным фундаментом. На втором курсе изучают базы данных — то, без чего не построить ни одно хранилище. На третьем — построение облачных и распределённых систем: это помогает понять, как данные хранятся и обрабатываются, когда их много. На четвёртом — Big Data и ETL-системы, то есть те самые процессы, через которые данные движутся от источника до хранилища. Программирование даётся на Java и 1С, а эти навыки легко переносятся на другие языки. Если после выпуска захочется углубиться в инженерию данных, часть знаний уже будет — остальное можно добрать на курсах или практике.
Уровень образования: высшее (бакалавриат)
Срок обучения: 3 года 6 мес. — 4 года 6 мес
Формы обучения: очная, очно-заочная
Документ об окончании: диплом бакалавра государственного образца«Информационные системы и технологии» (бакалавриат, Дубай)
Программа готовит разработчиков полного цикла: студенты изучают программирование, проектирование систем, управление данными и кибербезопасность. Обучение идёт очно в Дубае на английском — это погружение в международную ИТ-среду с первого курса.Эта программа шире, чем инженерия данных, но несколько дисциплин в ней пригодятся напрямую. С первого курса учат Python — основной язык для обработки данных. На втором — управление данными и администрирование баз данных: студенты разбираются, как устроены хранилища и как ими управлять. На третьем — проектирование систем больших данных: это про то, как организовать хранение и обработку, когда данных много. Отдельный блок посвящён безопасности операционных систем и баз данных — важная часть работы с данными, особенно если они конфиденциальные. Плюс архитектура вычислительных систем и построение сетей: это помогает понимать, как данные передаются между серверами.
Уровень образования: высшее (бакалавриат)
Срок обучения: 4 года
Форма обучения: очная (в Дубае, на английском языке)
Документ об окончании: диплом бакалавра государственного образца с европейским приложением к диплому
Курсы
Курсы подойдут, когда надо быстро войти в профессию. Хорошая программа за несколько месяцев даёт базу по SQL, Python и работе с данными. Выпускники получают сертификат или диплом о профессиональной переподготовке. С ним уже можно откликаться на вакансии.
Но есть нюанс. Многие курсы дают лишь основы, а работодатель хочет видеть, что человек реально умеет. Если после курса нет ни одного собственного проекта, документ мало чем поможет — он только показывает, что человек прошёл обучение. Поэтому, выбирая курсы, обращайте внимание, будет ли практика во время учёбы. Если да, то так вы сформируете первое портфолио.
В Университете «Синергия» подойдут программы:
«Python-разработчик» (курс)
Курс для тех, кто хочет освоить Python с нуля. Python — один из самых удобных языков для работы с данными: на нём пишут скрипты для загрузки и обработки информации, строят конвейеры и обучают модели. Программа даёт базу, которая пригодится дата-инженеру: основы языка и работу с API, SQL и PostgreSQL, Linux и Docker, алгоритмы и структуры данных, асинхронность и Git. Отдельная ценность — преподаватели: среди них есть действующие дата-инженеры, поэтому студенты видят не только теорию, но и реальные задачи из профессии. Это хороший старт: Python, SQL и Linux — фундамент, на котором строится инженерия данных, а остальное можно добрать на практике.Практики здесь тоже хватает. Студенты участвуют в хакатонах — это командные проекты, где за ограниченное время нужно собрать работающее решение, — и проходят лайвкодинг: пишут код в реальном времени, как на техническом собеседовании. Такая подготовка помогает не только освоить язык, но и научиться применять его под давлением дедлайна.
Уровень образования: дополнительное профессиональное (ДПО)
Срок обучения: 6 месяцев
Формат обучения: онлайн
Документ об окончании: диплом о профессиональной переподготовке или именной сертификат«Основы SQL» (курс)
SQL — язык, на котором дата-инженер разговаривает с базами данных: без него не построить ни один конвейер и не достать данные из хранилища. За два месяца курс даёт базу: как устроены базы данных, как связаны таблицы, как писать запросы и подзапросы, что такое нормализация и ключи. Это не полноценная подготовка по профессии, а стартовый курс — но именно с него удобно начинать тем, кто с SQL пока незнаком. Дальше можно двигаться к ETL-процессам и работе с хранилищами.Уровень образования: дополнительное профессиональное (ДПО)
Срок обучения: 2 месяца
Формат обучения: онлайн
Документ об окончании: диплом о профессиональной переподготовке или именной сертификат«Введение в анализ больших данных» (курс)
Курс для тех, кто хочет понять, что такое Big Data и как устроена инфраструктура для работы с большими объёмами информации. За месяц слушатели разбираются, откуда берутся большие данные, чем отличаются структурированные и неструктурированные данные, как устроены SQL/NoSQL, Hadoop и Data Lake, как применяют машинное обучение и нейросети. Это вводный курс: он даёт общую картину технологий, с которыми работает дата-инженер, и помогает понять, какое направление ближе. Практических инструментов вроде Spark или Airflow здесь не будет — но после обучения проще выбрать, что осваивать дальше.Уровень образования: дополнительное профессиональное (ДПО)
Срок обучения: 1 месяц
Формат обучения: онлайн
Документ об окончании: диплом о профессиональной переподготовке или именной сертификат
Самообразование
Есть и бесплатный путь: открытые лекции, документация, туториалы, книги. Можно двигаться в своём темпе, сразу пробовать на практике, собирать проекты.
Этот путь хорош гибкостью и тем, что не нужно никому платить. Но он требует сильной самодисциплины: без внешнего дедлайна многие бросают учёбу на середине. И документа об образовании по итогам вы не получите — только портфолио.
Для первой работы важнее всего портфолио
Диплом или сертификат показывают, что человек чему-то учился, но работодатель хочет увидеть, что он умеет делать. Хороший проект для портфолио выглядит так: данные приходят из нескольких источников, обрабатываются, загружаются в хранилище и обновляются автоматически. Если есть такой проект в добавление к диплому, то шансы устроиться на работу резко вырастают.
Однако обесценивать диплом не нужно. Да, небольшие компании часто готовы принять человека с одним лишь портфолио. Однако крупные организации обычно требуют профильный диплом о высшем образовании. Поэтому, если есть возможность совместить учёбу и практику, это лучший вариант.
Какой путь выбрать
Если нужна системная подготовка и диплом об образовании — однозначно вуз. Если важно как можно скорее освоить базовые инструменты и начать работать — курсы или самообразование.
При этом маршруты не исключают друг друга. Можно начать с курсов и собственных проектов, а позже получить высшее образование, чтобы претендовать на более престижные позиции. И наоборот: студент вуза может параллельно проходить курсы и собирать проекты, чтобы к выпуску у него были и диплом, и портфолио.
Читайте также:

Свидетельство о регистрации средства массовой информации ЭЛ № ФС77-76849


